Dit document beschrijft een op Docker gebaseerde systeemarchitectuur voor het Jottem-platform: een participatief digitaal erfgoedplatform waarin gebruikers media (jottems) uploaden, moderatoren deze beoordelen en publiceren, en annoteerders verrijkingen toevoegen. Het geheel wordt via subdomeinen onder iotm.nl ontsloten en implementeert de in het designdocument genoemde standaarden: IIIF Image API 3.0, IIIF Presentation API 3.0, IIIF Change Discovery, W3C Web Annotations, schema.org AP NDE, ARK en RSS.
1. Uitgangspunten
-
Open source first: elk component is een bewezen open-source product of een dunne maatwerklaag daaromheen. Succesvolle onderdelen zijn herbruikbaar tussen Time Machines.
-
Standaarden aan de buitenkant: alle publieke interfaces zijn standaard-API’s (IIIF, W3C Annotation Protocol, SPARQL/RDF, RSS), zodat harvesters en aggregators (o.a. NDE) zonder maatwerk kunnen aansluiten.
-
Duurzame opslag identificatie: elke gepubliceerde jottem krijgt een duurzame platform-URL met content negotiation naar HTML of RDF. Besluit: ARK-minting (NOID/UUID-objectnaam, resolver op ark.iotm.nl) is uitgesteld naar een latere fase - zie het keuzedocument in het designdocument; URL’s worden zo gekozen dat latere ARK-koppeling zonder linkbreuk kan.
-
Multi-tenant: een platforminstallatie bedient meerdere organisatiejottems (Streekarchief Midden-Holland, historische verenigingen, andere Time Machines), elk met eigen huisstijl, NAAN/shoulder en gebruikers.
-
Beheersbaarheid: het geheel draait als een docker-compose-stack op een enkele VPS (of dedicated server) en kan later doorgroeien naar Kubernetes zonder architectuurbreuk.
-
Getest en gemonitord: elk component wordt geautomatiseerd getest (unit, integratie, contract op de standaard-API’s en end-to-end over de stack) en draait onder centrale monitoring, logging en alerting, zodat regressies en storingen vroeg en aantoonbaar zichtbaar worden.
2. Contextdiagram
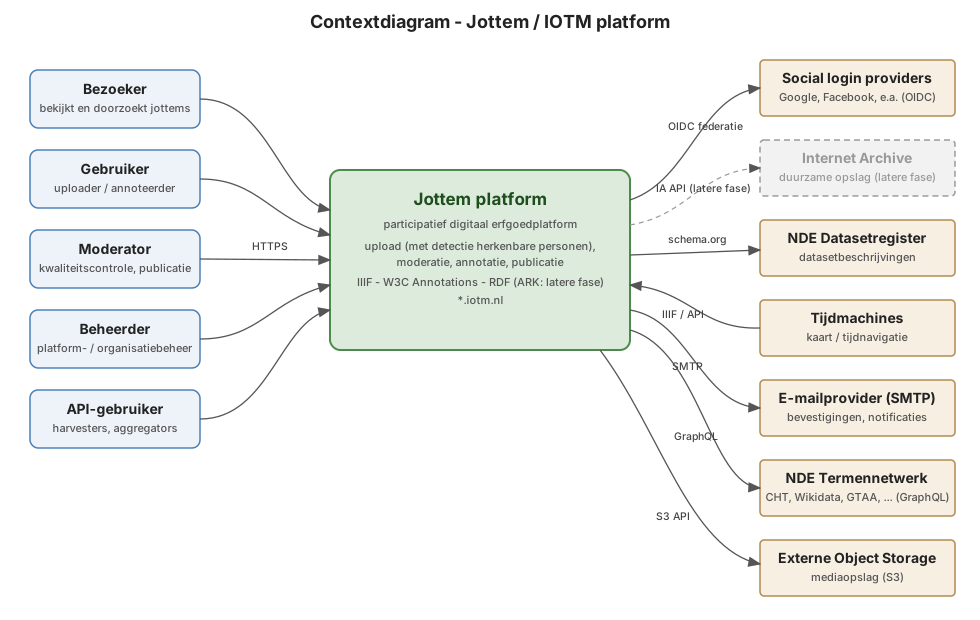
Het platform staat tussen vijf rollen (bezoeker, gebruiker/uploader/annoteerder, moderator, beheerder, API-gebruiker) en een aantal externe systemen: social login providers, het Internet Archive voor duurzame opslag (latere fase), het NDE Datasetregister, tijdmachines als kaart-/tijdinterface en het NDE Termennetwerk (GraphQL) als toegang tot terminologiebronnen (Cultuurhistorische Thesaurus, Wikidata, GTAA, ...) voor URI’s in metadata en annotaties.
3. Componentenoverzicht en subdomeinen
| Subdomein | Component | Open-source suggestie | Alternatieven |
|---|---|---|---|
www.iotm.nl
| Webfrontend | Next.js of SvelteKit + Mirador/Tify (IIIF-viewer), Annotorious (annoteren), MapLibre GL (kaart) | Nuxt, Universal Viewer, OpenSeadragon + eigen UI |
api.iotm.nl
| Backend-API (REST, IIIF Presentation, Change Discovery, RSS, zoeken) | FastAPI (Python) met iiif-prezi3 | NestJS, Laravel, Django REST Framework |
auth.iotm.nl
| Identity provider (OIDC, social login, 2FA/passkeys) | Authentik (gekozen) | Keycloak, Ory Kratos/Hydra |
iiif.iotm.nl
| IIIF Image API 3.0 + HTTP-cache | Cantaloupe achter Varnish | iipsrv, SIPI, go-iiif; nginx proxy_cache |
anno.iotm.nl
| W3C Web Annotation server | AnnoRepo (gekozen; miiify uit de eerdere versie van dit document is read-only geworden) | miiify, SimpleAnnotationServer, Annotot |
ark.iotm.nl
| ARK-resolver en -minter | Arklet (Internet Archive) | eigen microservice + noid-bibliotheek (pynoid) |
data.iotm.nl
| RDF-publicatie (schema.org AP NDE), SPARQL, datadumps, datasetbeschrijvingen, en de zelfbeschrijving van de data: het vocabulaire achter jottem: plus de JSON-LD-frames (/ns/)
| Apache Jena Fuseki; het /ns/- en /project/-pad wordt door de API bediend
| Oxigraph, QLever, Virtuoso OS |
| (intern) | Zoekmachine | Elasticsearch (genoemd in requirements) | OpenSearch |
| (intern) | Relationele database | PostgreSQL | MariaDB |
| (intern) | Cache en taakwachtrij | Valkey (gekozen; Redis-compatibel) | Redis, RabbitMQ (queue) |
| (extern) | Mediaopslag (S3) | Externe Object Storage-dienst (gekozen) | MinIO (zelf gehost) |
| (intern) | Detectie herkenbare personen | Herkenbaar API (eigen dienst: FastAPI + YOLO-pose) | cloud vision API’s (vallen af: beelden moeten on-premise blijven) |
| (intern) | Suggesties bij het uploaden | Suggesties API (eigen dienst: FastAPI + Florence-2 + SigLIP 2) | cloud vision API’s (vallen af: beelden moeten on-premise blijven); één meertalig VLM (te traag zonder videokaart) |
| (intern) | Async workers | Celery (bij FastAPI) of BullMQ (bij NestJS) | RQ, Sidekiq |
| (edge) | Reverse proxy, TLS | Traefik | Caddy, nginx-proxy + acme-companion |
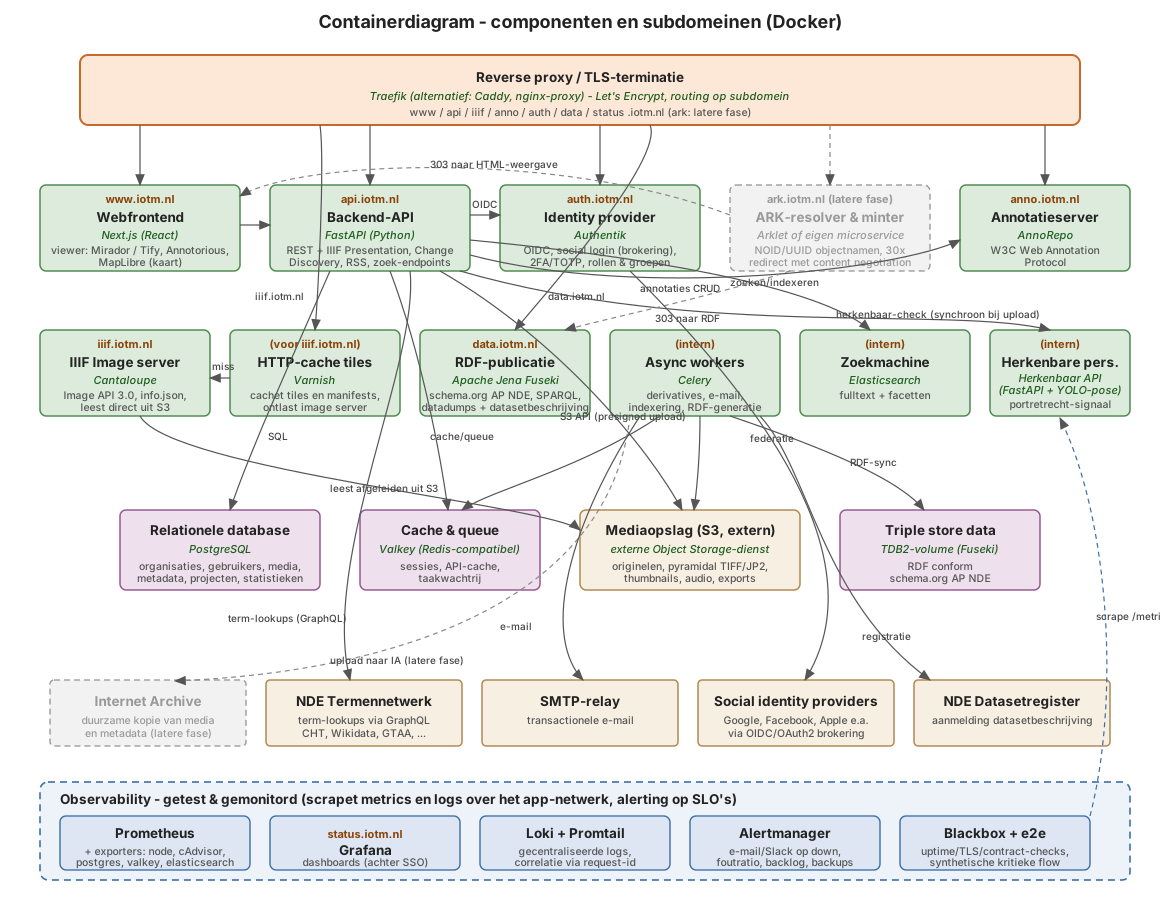
De volgende paragrafen lichten de belangrijkste componenten toe.
3.1. Reverse proxy (Traefik)
Traefik termineert TLS (automatisch via Let’s Encrypt), routeert op subdomein naar de juiste container via Docker-labels, en voegt security headers en rate limiting toe. Alle publieke componenten hangen aan het edge-netwerk; datastores zijn uitsluitend intern bereikbaar.
De rate limiting is per IP-adres met burst, het strengst op de endpoints die dure backends raken. Indicatieve startwaarden (bij te stellen op basis van monitoring): zoek-API en SPARQL 5 req/s (burst 15), beheer-API en meldingen/rapporteren 2 req/s (burst 5), annotatie- en metadata-reads 30 req/s, IIIF-tiles en thumbnails ruim (die komen vrijwel altijd uit de Varnish-cache). Overschrijding levert 429 Too Many Requests met Retry-After; bulk-afnemers worden naar de datadumps en feeds verwezen.
3.2. Authenticatie en autorisatie (Authentik)
Authentik fungeert als centrale OIDC-provider op auth.iotm.nl en doet uitsluitend authenticatie: registratie voor bezoekers, social login via federatie (MVP: Google, Microsoft en Facebook; Apple en Instagram volgen in fase 2 vanwege de aanvraag- en reviewdoorlooptijd), wachtwoord-login, TOTP-2FA en passkeys (WebAuthn). Voor accounts die via een beheeruitnodiging binnenkomen dwingt de enrollment-flow het instellen van een wachtwoord én een tweede factor (TOTP of passkey) af.
Autorisatie: de database is leidend. Rollen staan niet in de IdP maar in GebruikerRol (per organisatie, meerdere rollen per gebruiker - zie het ERD in de data-architectuur). De backend koppelt het access-token via de sub-claim aan een Gebruiker-rij en bepaalt daarna zelf de rechten (bijv. "moderator van organisatie X mag alleen jottems van X beoordelen"). Zo blijven de uitnodigings- en beheerflows in de applicatie-UI, is er geen groepensynchronisatie met de IdP nodig en is er één bron van waarheid voor rollen.
De werking in de praktijk: een FastAPI-dependency (auth-middleware) valideert per request het access-token (handtekening, expiry, amr), zoekt via de sub-claim de gebruiker en diens GebruikerRol-rijen op en hangt die als principal aan de request. De rollen-lookup wordt per sub kort gecachet in Valkey (TTL orde van een minuut); bij elke rolwijziging via de beheer-API wordt die cache-entry direct geïnvalideerd, zodat intrekking vrijwel meteen effect heeft zonder dat elke request de database raakt.
Het JWT-claims-contract dat de backend van Authentik nodig heeft, is daarmee klein:
| Claim | Gebruik |
|---|---|
sub
| stabiele koppeling token → Gebruiker (bij eerste login wordt de rij aangemaakt of aan de uitgenodigde rij gekoppeld)
|
email, email_verified
| e-mailadres (uitnodigingen, notificaties) |
name / preferred_username
| weergavenaam (zie Gebruiker.naamPubliek voor publicatie)
|
amr (auth-methode)
| de backend eist een sterke factor (TOTP of passkey) voor endpoints die een beheer- of moderatierol vragen |
De uitnodigingsflow: de beheer-API verstuurt de uitnodigingsmail met bevestigingslink en zet de GebruikerRol klaar; de link leidt naar een Authentik-enrollment-flow (wachtwoord + verplichte tweede factor: TOTP of passkey); bij de eerste login koppelt de backend de sub aan de uitgenodigde Gebruiker-rij.
Fijnmazige autorisatie op objectniveau (eigen afgekeurde jottems verwijderen, goedgekeurde niet) hoort in de backend thuis; wie dit declaratief wil, kan een policy engine als Casbin of OpenFGA toevoegen, maar voor deze schaal volstaat autorisatielogica in de API-laag.
3.3. Backend-API en frontend
De backend-API op api.iotm.nl is het maatwerkhart van het platform. Hij implementeert het datamodel uit het ERD (organisatie, project, gebruiker, media, metadata, favoriet) op PostgreSQL en biedt:
-
REST-endpoints voor upload (via presigned S3-URL’s, zodat grote bestanden niet door de API stromen), moderatieworkflow, projecten, favorieten, materiaaltypes/genres en koppelingen naar externe archiefbronnen (label + URI);
-
IIIF Presentation API 3.0: per jottem een manifest, per organisatie/project een collection, gegenereerd uit de database met een bibliotheek als iiif-prezi3;
-
IIIF Change Discovery 1.0: een ActivityStreams-feed per organisatie met create/update-activiteiten (inclusief nieuwe annotaties) voor harvesters;
-
RSS-feeds per organisatie met nieuwe jottems;
-
zoek-endpoints die Elasticsearch bevragen (fulltext, facetten op genre, organisatie, periode, plaats);
-
een proxy op de GraphQL API van het NDE Termennetwerk voor term-lookups (genres via de Cultuurhistorische Thesaurus, term-URI’s), beperkt tot de per project ingestelde terminologiebronnen;
-
statistieken voor beheerders en moderatoren.
De frontend op www.iotm.nl is een aparte container (Next.js of SvelteKit) met de publieke site, de HTML-weergave per jottem (IIIF-viewer + metadata + annotaties), de upload- en moderatie-omgeving, en de interactieve kaart. Voor het tekenen van vlakken op afbeeldingen en het vastleggen van geo-annotaties (standpunt fotograaf, zichtveld als WKT/GeoJSON) is Annotorious in combinatie met OpenSeadragon/Mirador en MapLibre een beproefde keuze; de kaartweergave kan via IIIF en de API gekoppeld worden aan tijdmachines (zoals de Gouda Tijdmachine).
Beoordelen vraagt een eigen scherm. Een moderator kan niet worden doorgestuurd naar de publiekspagina van de bijdrage waarover hij moet beslissen: die pagina bestaat pas ná goedkeuring, en er is dan ook nog geen IIIF-derivaat om te tonen. Daar komt bij dat de publiekspagina op de server wordt opgebouwd, waar de sessie van de moderator niet bestaat, dus zelfs een uitzondering in de rechten zou daar niets opleveren. De moderatieomgeving heeft daarom een eigen beoordeelweergave die de gegevens vanuit de browser ophaalt: het origineel via een tijdelijke link, alle metadata die de inzender opgaf, de herkomst, wie het inzond en of diens naam straks in de open data komt, plus het signaal over herkenbare personen met de verklaring over toestemming. Die laatste gegevens komen uit een aparte, rolgebonden respons en niet uit de detailweergave, want dat is dezelfde weergave die de publiekspagina voedt.
3.4. IIIF Image API (Cantaloupe + Varnish)
Cantaloupe serveert op iiif.iotm.nl de Image API 3.0 (info.json, tiles, regio’s, formaten) en leest bronbestanden rechtstreeks uit de S3-opslag (S3Source). Bij goedkeuring van een jottem maakt een worker met libvips een pyramidal TIFF als afgeleide (tegels van 256 pixels, JPEG-compressie), wat tiling zonder zware rekenlast mogelijk maakt. Varnish (of nginx proxy_cache) staat ervoor en cachet tiles en info.json agressief; gepubliceerde beelden zijn immutable, dus lange TTL’s zijn veilig. Zo blijft de image server ook bij piekverkeer (bijv. na een oproep in lokale media) responsief.
Een beeld weer weghalen. Diezelfde lange TTL werkt tegen je zodra een jottem wordt teruggetrokken. Het beeld staat dan op drie plekken: het derivaat in de objectopslag, een info.json in het geheugen van Cantaloupe en tegels in Varnish. Alleen de status omzetten raakt geen van drieën, dus wie de URL kent blijft de foto zien; voor een gehonoreerd verwijderverzoek of een portretrechtbezwaar is dat niet acceptabel (acceptatiecriterium MO-5). Bij depublicatie haalt de worker daarom het derivaat weg en maakt hij in één opdracht alle IIIF-URL’s van dat beeld ongeldig (een ban op de identifier; een purge werkt per exacte URL en de viewer heeft tientallen tegels opgehaald). Cantaloupe staat op resolve_first en purge_missing, zodat hij het ontbrekende bronbestand opmerkt en zijn eigen cache leeggooit. Het origineel blijft staan: dat is het archiefexemplaar, alleen bereikbaar via de API, en daaruit is het derivaat opnieuw te maken als een besluit wordt teruggedraaid.
De purge-opdracht zelf is een beheeractie en hoort achter een slot. Een IP-acl volstaat daarvoor niet: publiek verkeer komt via de reverse proxy binnen en draagt dus een intern adres, waardoor zo’n acl in de praktijk iedereen binnenlaat. De cache accepteert een purge of ban alleen met een gedeeld geheim, en weigert beide zolang dat geheim niet is ingesteld.
Afweging. De kandidaten zijn beoordeeld op ondersteuning van de Image API 3.0, het kunnen lezen uit objectopslag, beheerslast en de mate waarin de erfgoedsector er ervaring mee heeft.
| Optie | Voordelen | Nadelen |
|---|---|---|
| Cantaloupe (gekozen) | Volwassen en veel gebruikt in de erfgoedsector; Image API 3.0 uit de doos; S3Source leest bronbestanden rechtstreeks uit de objectopslag, zodat de server zelf geen persistente opslag nodig heeft; volledig configureerbaar via omgevingsvariabelen; laat zich achter een cache verbergen zonder eigen publieke route
| Java: een JVM met een vaste heapgrens is de facto de bovengrens voor gelijktijdige tile-decodes; vraagt een eigen derivatenstap (pyramidal TIFF) vóór de server; de Image API 3.0 beantwoordt een !w,h-verzoek op een kleiner bronbeeld terecht met een 400, wat bij verkleinen om expliciete logica vraagt
|
| IIPImage (iipsrv) | C++, zeer snel en licht; de meest gebruikte IIIF-imageserver, volledig level 2 en conform Image API 1, 2 en 3; sterk op zeer grote beelden en wetenschappelijke formaten | Werkt op lokale bestanden, dus objectopslag vraagt een tussenstap (mount of synchronisatie); deployment via FastCGI achter Apache of nginx past minder in een containerstack; configuratie hoort bij de webserver in plaats van bij de dienst |
| wolpi (dbmdz) | Gebruikt libvips, dezelfde bibliotheek waarmee het platform al derivaten maakt; Image API 2.1 en 3.0; uitbreidbaar met extensies in JavaScript of Python voor autorisatie, identifier-resolutie, aanvulling van info.json, caching en eigen uitvoerformaten; MIT-licentie
| Jong en klein project met weinig gebruikers buiten de maker; vereist een recente Java-versie; geen brede praktijkervaring in de erfgoedsector; in dit project niet beproefd, dus de beoordeling berust op de projectdocumentatie |
| SIPI, go-iiif | SIPI: C++, Image API 3.0-compleet, ontwikkeld door de Zwitserse erfgoedsector (DaSCH). go-iiif: Go, eenvoudig te deployen als één binary | SIPI heeft een kleine community; go-iiif is minder featurerijk en mist onder meer de bronopties die hier nodig zijn |
Besluit. Cantaloupe, met Varnish ervoor. Doorslaggevend zijn S3Source (het platform bewaart alles in objectopslag, dus een server die daar rechtstreeks uit leest scheelt een hele synchronisatielaag) en de brede toepassing in de erfgoedsector. De prijs is het geheugenbeslag van de JVM en een eigen derivatenstap in de worker. Die prijs valt mee doordat het platform verder uitsluitend de standaard aanspreekt en niet het product: dezelfde code bedient ook de IIIF-services van externe beeldbanken, dus de imageserver is aantoonbaar inwisselbaar.
Herzien wanneer. Het geheugenbeslag van de JVM knelt op de server, of de derivatenpijplijn wordt zwaarder dan de imageserver zelf. wolpi is dan de eerste kandidaat om te beproeven, omdat het op dezelfde libvips draait die het platform al gebruikt.
3.5. Annotaties (AnnoRepo)
AnnoRepo (KNAW Humanities Cluster) implementeert het W3C Web Annotation Protocol volledig, inclusief de schrijf-API, met autorisatie via api-keys en per container publiek-leesbare toegang (readOnlyForAnonymousUsers); opslag in MongoDB. Het eerder gekozen miiify is in 2025-2026 omgebouwd tot een read-only server (schrijven kan daar alleen nog via git-bestanden met een compileerstap), wat niet past bij live annoteren met moderatie; vandaar deze wissel. De frontend schrijft annotaties (vlak-identificaties van personen/gebouwen/bedrijven met naam + URI, plaatsnamen, gebeurtenissen, archiefbronkoppelingen, vrije tekst en reacties) via de backend-API naar AnnoRepo; de API voegt daarbij de geauthenticeerde gebruiker als creator toe (of anonimiseert, afhankelijk van naamPubliek), valideert de verrijking tegen de projectinstellingen en bewaakt autorisatie (bewerken/verwijderen van eigen annotaties). De versiegeschiedenis van elke annotatiemutatie wordt met volledige payload vastgelegd in het Gebeurtenislog. Lezen kan publiek en standaardconform via anno.iotm.nl (containers per jottem: /w3c/{jottemId}/), zodat externe partijen annotaties per jottem kunnen ophalen en doorzoeken.
De context is de verantwoordelijkheid van de schrijver. Een annotatie draagt naast de W3C-context ook de eigen naamsruimte, want jottem:verrijking en jottem:aard zijn zonder die prefix onvindbaar. AnnoRepo bewaart die context en geeft hem terug op de eigen IRI van de annotatie, maar haalt hem weg uit de items van een containerlijst: die erven de context van de pagina. Dat is verdedigbaar, maar het legt een valkuil klaar. Wie zo’n item uit een lijst leest, er iets aan verandert en het terugschrijft, maakt de gestripte vorm tot de opgeslagen vorm; daarna is op de canonieke IRI niets meer op te lossen, ook type, body en target niet. Precies dat gebeurde bij de synchronisatie van een gewijzigde inzendernaam. De schrijfroute zet de context er daarom zelf bij wanneer die ontbreekt, zodat geen enkele aanroeper dit nog kan veroorzaken, en een contracttest haalt annotaties op hun eigen IRI op om te toetsen dat ze zelfbeschrijvend blijven.
Wat overblijft is een beperking van de annotatieserver: de paginaweergave die AnnoRepo zelf opbouwt draagt uitsluitend de W3C-context, en een container kan geen eigen prefix bewaren. In die weergave zijn de jottem:-velden dus onoplosbaar, ook bij een gave annotatie. De eigen verzamelroutes (/project/{id}/annotations, /organisatie/{slug}/annotations) zetten de prefix er wel bij, die sinds de verhuizing van het vocabulaire naar data.iotm.nl/ns/jottem.jsonld# uit één definitie in de API komt; voor de weergave op de annotatieserver zelf ligt de oplossing bij het project, waar dit is gemeld als knaw-huc/annorepo#320. Het datamodel staat uitbreidingen uitdrukkelijk toe (Web Annotation Data Model §3.3) maar verbiedt de items in een pagina een eigen context (§5.2); dan moet de context van de pagina die prefixen kunnen dragen, anders is een uitbreiding in een paginaweergave per definitie onbruikbaar.
Afweging. Het oorspronkelijke ontwerp koos miiify. Bij de realisatie bleek dat product te zijn omgebouwd tot een read-only server, waarna de kandidaten opnieuw zijn beoordeeld op één harde eis: een schrijfbaar W3C Annotation Protocol, want annoteren met moderatie gebeurt live.
| Optie | Voordelen | Nadelen |
|---|---|---|
| AnnoRepo (KNAW HuC, gekozen) | Volledig W3C Web Annotation Protocol inclusief schrijven; actief onderhouden en in gebruik bij Nederlandse onderzoeksprojecten; autorisatie met api-keys en per container readOnlyForAnonymousUsers, dus publiek lezen en schrijven alleen via de eigen API; container per jottem via de Slug-header; ETag/If-Match voor optimistic locking; server-side paginering; batch-upload en een zoek-API beschikbaar voor later
| Brengt MongoDB als tweede datastore mee; het autorisatiemodel kent alleen een root-api-key, geen service-accounts; de server kent geen gebruikers, eigenaarschap, validatie of versiegeschiedenis, dus dat blijft platformwerk; elke wijziging kost twee aanroepen (eerst de ETag ophalen); een naamswijziging betekent alle annotaties van die gebruiker herschrijven; de containerpaden gebruiken /w3c/, wat afwijkt van het /annotations/-pad uit het oorspronkelijke ontwerp
|
| miiify, huidige versie (The National Archives UK) | Versiebeheer met git als opslagmodel, dus elke mutatie is herleidbaar zonder eigen historie; geen database nodig; MIT-licentie; goed schaalbaar in de leesrichting | Uitsluitend leesbaar: annotaties komen er als git-bestanden in, gevolgd door een compileerstap. Daarmee valt live annoteren met moderatie af |
| miiify, bevroren image uit 2024 | Heeft de schrijf-API nog wel en zou het oorspronkelijke ontwerp letterlijk volgen | Software zonder onderhoud, dus een groeiend beveiligings- en beheerrisico; moderatie (verbergen) en anonimisering zijn er lastig in te passen |
| Eigen opslag in PostgreSQL | Alles in één database; moderatie, autorisatie en anonimisering direct geïntegreerd; geen extra dienst in de stack | Het platform zou dan zelf een publieke standaard implementeren en onderhouden, terwijl die juist extern herbruikbaar moet zijn; meer eigen code op precies het vlak waar standaardsoftware bestaat |
| SimpleAnnotationServer, Annotot | Beproefd in IIIF-viewers, klein en eenvoudig | Gericht op oudere annotatiemodellen (OpenAnnotation) of op een Rails-omgeving; geen actieve doorontwikkeling op het huidige W3C-protocol |
Besluit. AnnoRepo. Het is de enige kandidaat die het volledige W3C-protocol inclusief schrijven biedt én actief onderhouden wordt, waardoor het platform de standaard aan de buitenkant echt kan waarmaken in plaats van hem zelf na te bouwen. De prijs is MongoDB als extra datastore en het feit dat de versiegeschiedenis in het Gebeurtenislog van het platform leeft in plaats van in de annotatieserver, een bewuste afwijking van het oorspronkelijke ontwerp. Omdat AnnoRepo geen gebruikersbegrip kent, blijven creator, validatie en eigenaarschap werk van de backend-API; dat is tegelijk de reden dat schrijven uitsluitend via die API loopt.
Herzien wanneer. De aggregatie over containers niet meer met een cache is af te vangen (dan wordt de zoek-API van AnnoRepo in gebruik genomen in plaats van een aanroep per jottem), of wanneer er een schrijfbare opvolger van miiify verschijnt. Een wissel raakt vooral de clientmodule van de backend; wél zijn de annotatie-IRI’s publiek gepubliceerd in manifesten en RDF, dus een andere URL-vorm vraagt om een migratie van bestaande verwijzingen.
3.6. Detectie herkenbare personen (Herkenbaar API)
De Herkenbaar API is een eigen dienst (FastAPI met een YOLO-pose-model via ultralytics) die bepaalt of op een afbeelding herkenbare personen staan, ten behoeve van het portretrecht en de privacy-eisen uit het designdocument. De dienst draait als interne container op het app-netwerk en is niet publiek bereikbaar.
De backend-API roept de dienst synchroon aan bij het aanmaken van een jottem: na de upload (via presigned URL naar de mediaopslag) haalt de backend het detectieresultaat op en slaat dit op bij de media (herkenbaar ja/nee plus betrouwbaarheid). Bij "herkenbaar: ja" vraagt de frontend de uploader direct om een toestemmingsverklaring van de afgebeelde personen; de moderator ziet het detectiesignaal en de verklaring bij de kwaliteitscontrole. De detectie is een hulpmiddel - de moderator beslist.
Privacy-uitgangspunt: de inferentie draait volledig op de eigen server; beelden verlaten het platform niet en er worden geen gezichtsherkennings- of identificatietechnieken gebruikt, uitsluitend detectie van de aanwezigheid van herkenbare personen.
3.7. Uploaden in twee stappen
Het uploadformulier loopt in twee stappen: eerst alleen de foto (bestand, camera, een permalink uit een beeldbank of een foto-URL), dan de gegevens erbij. Die knip verlaagt de drempel, en levert bovendien een moment op waarop het beeld al bekend is en het platform kan meedenken.
Afweging. Een vroege terugkeer per stap binnen dezelfde pagina (gekozen) tegenover een eigen route per stap, of alles op één pagina met alleen visuele groepering. De eerste wint omdat de ingevulde gegevens vanzelf blijven staan en het patroon er al was voor het toestemmingsscherm bij herkenbare personen; een eigen route zou de halve upload deelbaar maken via een URL, wat niets oplevert en de terugkeer na inloggen ingewikkelder maakt.
Wanneer het bestand naar de opslag gaat. Aan het eind van stap 1, niet pas bij het indienen. Alleen dan kunnen de controle op herkenbare personen en de suggestiedienst draaien vóórdat de inzender aan de gegevens begint. De prijs is dat er bestanden in de objectopslag komen van formulieren die nooit worden afgemaakt; die verweesde objecten vragen een opruimtaak.
De volgorde tussen de twee stappen. Direct na de foto draait de controle op herkenbare personen, en zijn die er, dan komt de toestemmingsvraag meteen: nog vóór het metadataformulier. Eerder stond die vraag aan het eind, na het invullen; wie dan annuleerde was al zijn typewerk kwijt, en dat is precies het moment waarop iemand afhaakt. De keuze wordt geparkeerd en pas bij het indienen meegestuurd, want vroeg indienen kan niet: titel en licentiebevestiging bestaan dan nog niet.
Het vangnet blijft bestaan. De backend draait de controle bij het indienen altijd zelf opnieuw en negeert wat de frontend zag; vindt de server alsnog personen terwijl de clientcontrole niets zag (bijvoorbeeld doordat de dienst even weg was), dan komt de vraag daar alsnog.
De wachtverzachter. De suggestiedienst start meteen na de foto en loopt door terwijl de inzender de toestemmingsvraag leest. Is hij daarna nog bezig, dan verschijnt een wachtscherm met een geanimeerde vis, getekend naar het beeldmerk. Dat scherm blijft minstens ruim een seconde staan zodat het niet knippert, hooguit vijftien seconden zodat een trage of afwezige dienst niemand ophoudt, en is met "ga alvast verder" over te slaan. De beweging is CSS, zodat de platformbrede regel voor prefers-reduced-motion hem uitzet.
Alle vier de uploadwijzen gelijk. Ook een beeldbank-permalink en een foto-URL doorlopen deze volgorde. De controle- en suggestie-endpoints accepteren daarvoor naast een mediaId ook een externe bron, die de server zelf ophaalt (voor IIIF een verkleinde versie), zoals hij bij het indienen al deed. Eerder sloegen die twee wijzen beide controles over en kwam de toestemmingsvraag daar pas als de server bij het indienen weigerde.
Gegevens uit de beeldbank. Bij een permalink bevat het IIIF-manifest de beschrijving al: titel, samenvatting, datering en vervaardiger. Die worden overgenomen als voorstel, met een regel eronder waar ze vandaan komen. In de praktijk blijkt het manifestlabel niet altijd bruikbaar (een beeldbank kan er letterlijk "No title" of de archiefcode van het scanbestand in zetten), dus de titel komt uit de eerste kandidaat die als titel doorgaat, met de beschrijving uit het metadatablok als terugval.
3.8. Suggesties bij het uploaden (Suggesties API)
De Suggesties API is een eigen dienst (FastAPI met Florence-2 voor het onderschrift, een Marian-vertaalmodel en SigLIP 2 voor de zero-shot-classificatie) die bij een eigen foto een titel, een categorie en steekwoorden voorstelt. De dienst draait als interne container en is niet publiek bereikbaar; de afweging per model staat in het verrijkingenhoofdstuk, Suggesties bij het uploaden.
De backend roept de dienst aan tussen stap 1 en stap 2 van het formulier: het beeld staat dan al in de objectopslag. De frontend wacht er niet op. Levert de dienst niets op, dan blijven de velden leeg en merkt de inzender daar niets van; net als bij het Herkenbaar-signaal is dit een hulpsignaal en geen poortwachter. Voorstellen worden nooit ongevraagd opgeslagen: alleen een leeg titelveld wordt alvast gevuld, met vermelding dat de computer het voorstelde, en categorie en steekwoorden staan als klikbare voorstellen onder het veld.
Anders dan de Herkenbaar API is deze dienst EUPL-1.2, gelijk aan de platformcode: de gebruikte modellen zijn MIT en Apache-2.0, dus er werkt geen AGPL door zoals bij ultralytics/YOLO. De licentiegrens valt daarmee nog steeds samen met de repogrens.
Privacy-uitgangspunt, gelijk aan de Herkenbaar API: de inferentie draait volledig op de eigen server, beelden verlaten het platform niet, en er wordt niet vastgesteld wie er op een foto staat.
Zolang de dienst wordt beproefd staat hij in het compose-profiel dev en is JOTTEM_SUGGESTIES_URL in productie leeg; een lege waarde betekent: geen suggesties (V-5).
3.9. RDF-publicatie en datasetbeschrijvingen (Fuseki)
Elke publicatie of wijziging triggert een worker die de jottem-metadata mapt naar RDF conform het schema.org-profiel van NDE (schema.org AP NDE) en deze upsert in Apache Jena Fuseki op data.iotm.nl. Daarmee ontstaat:
-
een resolvebare RDF-representatie per jottem (JSON-LD, Turtle, RDF/XML via content negotiation), met per kernentiteit een vastgelegd JSON-LD-frame voor de vorm van de JSON;
-
een SPARQL-endpoint per organisatie (aparte named graphs);
-
periodieke datadumps (N-Triples/Turtle, gzip) als distributie;
-
per organisatie een datasetbeschrijving als
schema:Datasetconform de NDE-requirements voor datasets, met de dump en het SPARQL-endpoint alsschema:distribution, aangemeld bij het NDE Datasetregister.
De mapping zelf kan in applicatiecode (rdflib) of declaratief met RML/CARML; voor een overzichtelijk model als dit is applicatiecode het eenvoudigst te onderhouden.
Afweging. De triplestore moet drie dingen goed doen: named graphs (Jottem herbouwt per project een volledige graaf), een publiek leesbaar SPARQL-endpoint, en beheersbaar blijven op één server.
| Optie | Voordelen | Nadelen |
|---|---|---|
| Apache Jena Fuseki (gekozen) | De referentie-implementatie van SPARQL 1.1: goed gedocumenteerd, stabiel en voorspelbaar; volwaardige named graphs plus het Graph Store Protocol, waarmee een projectgraaf in één idempotente aanroep te herbouwen is; instelbare querytimeout; TDB2 als persistente opslag | Java, dus een JVM met bijbehorend geheugenbeslag; een publiek endpoint vraagt om afscherming, want een query kan met SERVICE zelf verbindingen opzetten, en dure queries moeten worden begrensd; leesprestaties zijn niet de sterkste van het veld
|
| Oxigraph | Rust: zeer licht en snel, één binary, eenvoudige deployment en een klein geheugenprofiel | Jonger project met beperktere tooling en een kleinere gemeenschap; geen full-text search |
| QLever | C++: extreem snel op zeer grote datasets, ontworpen voor miljarden tripels | Overkill voor deze schaal en minder gangbaar als update-store, terwijl Jottem juist bij elke mutatie een graaf herschrijft |
| Virtuoso (open source) | Bewezen op schaal, onder meer als store achter DBpedia | Gedateerd beheersmodel; de open-source-versie is beperkter dan de commerciële, wat de duurzaamheid van de keuze vertroebelt |
Besluit. Fuseki. Doorslaggevend zijn het Graph Store Protocol, dat het herbouwen van een projectgraaf tot één aanroep terugbrengt, en de voorspelbaarheid van een referentie-implementatie: bij een platform dat zijn data juist als open data publiceert, weegt standaardgetrouwheid zwaarder dan snelheid. De prijs is het geheugenbeslag van de JVM en de noodzaak het endpoint zorgvuldig af te schermen. Daarom staat Fuseki in een eigen netwerksegment, is alleen het leespad publiek en lopen updates uitsluitend intern via de worker.
Herzien wanneer. Het geheugenbeslag knelt, of de dataomvang groeit zo dat leesprestaties gaan tellen. Oxigraph is dan de lichte kandidaat; de mapping en het Graph Store Protocol blijven daarbij gelijk, dus de wissel raakt vooral de deployment.
3.10. ARK-resolving (latere fase)
*In de MVP is de duurzame link een platform-URL met content negotiation (zie de URI-strategie in de data-architectuur); ARK-minting en -resolving zijn uitgesteld naar een latere fase (zie het keuzedocument). Onderstaande beschrijving legt vast hoe die fase eruitziet, zodat URL’s nu al ARK-klaar gekozen worden.*
Bij goedkeuring mint de backend een objectnaam (NOID via pynoid, of UUID) onder de NAAN en shoulder van de organisatie en registreert deze in de resolver op ark.iotm.nl. Arklet van het Internet Archive is hiervoor een lichtgewicht, S3- en Postgres-vriendelijke keuze; een eigen microservice van enkele tientallen regels is een reeel alternatief omdat de resolvelogica beperkt is. De resolver ondersteunt content negotiation en ARK-conventies zoals ?info voor metadata over het object zelf:
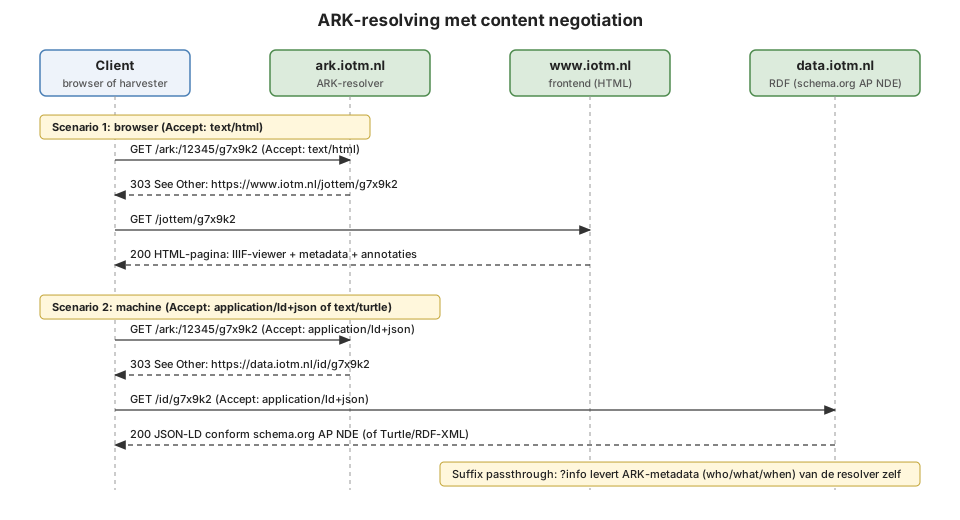
Belangrijk duurzaamheidsprincipe: de ARK-registry (koppeling ARK naar actuele locaties) staat in PostgreSQL en wordt meegenomen in de backup en in de metadata die naar het Internet Archive gaat, zodat resolving ook bij migratie van het platform herstelbaar blijft.
3.11. Dataopslag, caching en mediaopslag
PostgreSQL is de primaire bron van waarheid voor het volledige ERD en de moderatiestatussen (een ARK-registry volgt pas in de latere ARK-fase). Valkey (Redis-compatibel) dient drie doelen: sessie-/API-cache, rate limiting en de taakwachtrij voor de workers. De mediaopslag is een externe Object Storage-dienst (S3) - geen eigen opslagbeheer en de capaciteit groeit mee zonder serverwijziging - met gescheiden buckets: originals (niet publiek, alleen via API en workers), derivatives (pyramidal TIFF’s voor Cantaloupe), thumbs (publiek, lange cache-headers), audio voor audio-jottems zoals interviews (fase 2, zie de uploadscope in de requirements) en exports (e-depot-exportpakketten, beperkte bewaartermijn). Alle componenten spreken uitsluitend het S3-protocol, dus een zelf-gehost alternatief (MinIO) blijft transparant inwisselbaar; de leverancierskeuze is een exploitatiebesluit.
Caching gebeurt op drie niveaus: Varnish voor IIIF-tiles en manifests, Valkey voor API-responses (zoekresultaten, collections, statistieken) en HTTP-cache-headers plus ETags op alle publieke endpoints zodat ook harvesters efficient werken.
3.12. Async workers en Internet Archive
Een workerpool (Celery met Valkey als broker) handelt alles af wat niet in de request-cyclus hoort: genereren van derivatives en thumbnails, EXIF-extractie, e-mailnotificaties (goedkeuring, afkeuring met reden, uitnodigingen), Elasticsearch-indexering, RDF-synchronisatie naar Fuseki en e-depot-exports per project (BagIt + RO-Crate, zie de data-architectuur). De e-mail verlaat het platform via een eigen MTA in de stack (Postfix met DKIM-ondertekening), niet via een externe verzenddienst; de bijbehorende afleverbaarheidsmaatregelen (SPF/DKIM/DMARC, one-click unsubscribe, reverse DNS, bouncebeheer en reputatiemonitoring) staan in de notificatie-sectie van het ontwerpdocument. In fase 2 komen daar de conversiepipelines voor PDF (pagina’s naar afgeleiden voor Cantaloupe, multi-canvas Manifest) en audio (transcodering plus duration voor het IIIF-audio-canvas) bij. De Internet Archive-doorzetting van goedgekeurde media (via de internetarchive Python-client, met de IA-itemidentifier terug in de database en de RDF, bijv. als schema:archivedAt) behoort niet tot de MVP en volgt in een latere fase (zie het keuzedocument).
Betrouwbare doorwerking van mutaties (outbox). Het Gebeurtenislog uit het ERD fungeert als transactional outbox: elke mutatie die outputs raakt (goedkeuring, metadata-wijziging, annotatiemutatie, depublicatie) schrijft binnen dezelfde databasetransactie een logregel. De workers verwerken die regels asynchroon en idempotent naar Elasticsearch, de Fuseki named graph, de gecachte datadump van het project en een Varnish-purge/ban van de geraakte URL’s; pas na succes wordt de regel als verwerkt gemarkeerd, en bij falen wordt opnieuw geprobeerd met backoff. Een nachtelijke reconciliatiejob vergelijkt PostgreSQL met de zoekindex en de triplestore en repareert verschillen, zodat de outputs ook na een crash of storing aantoonbaar bijlopen.
4. Deployment met Docker
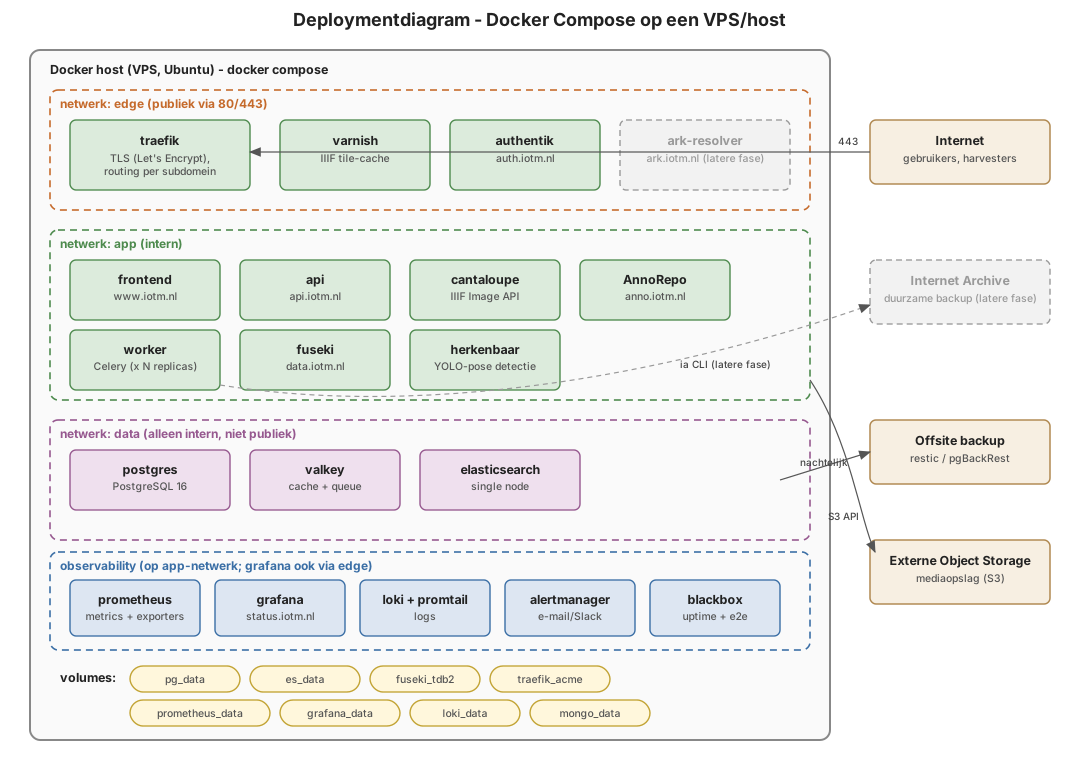
De stack draait met docker compose op een enkele host, met drie netwerken: edge (publiek via Traefik), app (interne servicecommunicatie) en data (datastores, niet publiek routeerbaar). Een indicatieve docker-compose.yml:
services : traefik : image : traefik:v3ports : ["80:80" ,"443:443" ]volumes : - /var/run/docker.sock:/var/run/docker.sock:ro - traefik_acme:/acmenetworks : [edge ]frontend : build : ./frontendlabels : -"traefik.http.routers.www.rule=Host(`www.iotm.nl`)" networks : [edge ,app ]api : build : ./apienvironment : DATABASE_URL : postgres://jottem@postgres/jottemREDIS_URL : redis://valkey:6379S3_ENDPOINT : https://s3.example-objectstorage.eu# externe Object Storage-dienst OIDC_ISSUER : https://auth.iotm.nl/application/o/jottem/ES_URL : http://elasticsearch:9200labels : -"traefik.http.routers.api.rule=Host(`api.iotm.nl`)" networks : [edge ,app ,data ]worker : build : ./apicommand : celery -A jottem workerdeploy : {replicas : 2 }networks : [app ,data ]authentik : image : ghcr.io/goauthentik/server:latestcommand : serverlabels : -"traefik.http.routers.auth.rule=Host(`auth.iotm.nl`)" networks : [edge ,data ]cantaloupe : image : uclalibrary/cantaloupe:latestenvironment : SOURCE_STATIC : S3Sourcenetworks : [app ,data ]varnish : image : varnish:stablelabels : -"traefik.http.routers.iiif.rule=Host(`iiif.iotm.nl`)" networks : [edge ,app ]mongo : image : mongo:6volumes : [mongo_data :/data/db ]networks : [app ]annorepo : image : ghcr.io/knaw-huc/annorepo-server:0.9.0labels : -"traefik.http.routers.anno.rule=Host(`anno.iotm.nl`)" networks : [edge ,app ]ark : image : internetarchive/arklet:latestlabels : -"traefik.http.routers.ark.rule=Host(`ark.iotm.nl`)" networks : [edge ,data ]fuseki : image : stain/jena-fuseki:latestlabels : -"traefik.http.routers.data.rule=Host(`data.iotm.nl`)" volumes : [fuseki_tdb2 :/fuseki ]networks : [edge ,app ]postgres : image : postgres:16volumes : [pg_data :/var/lib/postgresql/data ]networks : [data ]valkey : image : valkey/valkey:8networks : [data ]elasticsearch : image : elasticsearch:8.14.0environment : {discovery.type : single-node }volumes : [es_data :/usr/share/elasticsearch/data ]networks : [data ]herkenbaar : build : ./herkenbaar-apinetworks : [app ]prometheus : image : prom/prometheus:latestvolumes : [prometheus_data :/prometheus ]networks : [app ,data ]alertmanager : image : prom/alertmanager:latestnetworks : [app ]grafana : image : grafana/grafana:latestenvironment : GF_AUTH_GENERIC_OAUTH_ENABLED : "true" # SSO via Authentik labels : -"traefik.http.routers.status.rule=Host(`status.iotm.nl`)" volumes : [grafana_data :/var/lib/grafana ]networks : [edge ,app ]loki : image : grafana/loki:latestvolumes : [loki_data :/loki ]networks : [app ]promtail : image : grafana/promtail:latestvolumes : - /var/run/docker.sock:/var/run/docker.sock:ro - /var/lib/docker/containers:/var/lib/docker/containers:ronetworks : [app ]blackbox : image : prom/blackbox-exporter:latest# uptime/TLS/inhoud van publieke endpoints networks : [app ,edge ]cadvisor : image : gcr.io/cadvisor/cadvisor:latestvolumes : [/ :/rootfs :ro ,/var/run :/var/run :ro ,/sys :/sys :ro ]networks : [app ]node-exporter : image : prom/node-exporter:latestnetworks : [app ]volumes : traefik_acme : {}pg_data : {}es_data : {}fuseki_tdb2 : {}mongo_data : {}prometheus_data : {}grafana_data : {}loki_data : {}networks : edge : {}app : {internal : true }data : {internal : true }
Aanvullend op de kernstack: Prometheus + Grafana + Loki + Alertmanager voor monitoring, logging en alerting (met exporters per datastore en een blackbox-exporter voor de publieke endpoints), pgBackRest voor database-backups en restic voor nachtelijke offsite backups van alle volumes naar een tweede opslaglocatie; de externe mediabuckets worden separaat geback-upt (bijv. met rclone naar diezelfde backup-opslag). De Internet Archive-kopie van gepubliceerd materiaal (latere fase) voegt daar te zijner tijd een tweede duurzaamheidslaag aan toe. De inrichting van testen en monitoring is uitgewerkt in paragraaf 5.
5. Doorsnijdende aspecten
Privacy en auteursrecht. Persoonsgegevens staan uitsluitend in PostgreSQL en Authentik; verwijderingsverzoeken worden ondersteund doordat originelen alleen via de API bereikbaar zijn en gepubliceerde jottems een depubliceer-workflow kennen (verwijderen uit index, cache-purge in Varnish, tombstone op de duurzame URL). Toestemming voor herkenbare personen en het onderscheid herinnering versus verifieerbaar feit zijn metadatavelden in de moderatieworkflow, geen infrastructuurcomponent.
Multi-tenancy. Organisatiejottems delen dezelfde stack; scheiding gebeurt via organisatie-id in de database, named graphs in Fuseki, prefixen in S3 en Elasticsearch, identiteiten in Authentik (rollen in de database) en shoulders binnen de ARK NAAN. Huisstijl (logo, kleurenpalet, favicon) is configuratie in de database die de frontend per organisatie-slug toepast.
Geautomatiseerd testen. Het testen volgt de testpiramide en draait volledig in CI (GitHub Actions of Forgejo Actions), met een gate op elke pull request en een nachtelijke volledige run:
-
Unit- en integratietests op de maatwerkcomponenten: pytest (met httpx/testcontainers voor Postgres, Valkey, een S3-testcontainer en Elasticsearch) voor de backend-API en workers, Vitest/Jest plus Testing Library voor de frontend. Doelstelling is dekking op de bedrijfslogica (moderatieworkflow, autorisatie op objectniveau, ARK-minting, RDF-mapping), niet op boilerplate.
-
Contracttests op de publieke standaarden, zodat "standaarden aan de buitenkant" ook aantoonbaar blijft: de IIIF Presentation- en Image API-validators, de W3C Web Annotation Protocol-testsuite tegen
anno.iotm.nl, SHACL-validatie van de gegenereerde RDF tegen het schema.org AP NDE-profiel, smoke-queries op het SPARQL-endpoint en schemavalidatie van de RSS- en ActivityStreams-feeds. Deze tests bewaken dat harvesters (o.a. NDE) zonder maatwerk blijven aansluiten. -
End-to-end tests met Playwright over de docker-compose-stack, die de kritieke ketens doorlopen: registratie/inlog via Authentik → upload via presigned URL → moderatie → publicatie → duurzame link met content negotiation → IIIF-manifest en tiles → annotatie → verschijnen in zoekindex, RDF en Change Discovery-feed. Dezelfde suite draait als synthetische monitoring in productie (zie hieronder).
-
Third-party open-source componenten (Authentik, Cantaloupe, AnnoRepo, Fuseki) testen we niet zelf op unitniveau, maar dekken we af met health-/smoke-tests, versie-pinning en gecontroleerde updates via Renovate/Dependabot; de contract- en e2e-suite fungeert als regressienet bij elke image-update. Security scanning (Trivy op images, dependency-audit) hangt aan dezelfde pipeline.
Monitoring en observability. De observability-stack (Prometheus, Grafana, Loki, Alertmanager) uit paragraaf 4 wordt als volgt ingericht:
-
Metrics. De maatwerkcomponenten exposen Prometheus-metrics via de OpenTelemetry/Prometheus-client (request-latency en foutratio per endpoint, Celery-queuediepte en taakduur/faalratio, upload- en derivative-doorlooptijd). Voor de overige componenten leveren exporters de systeem- en dienststatistieken: node_exporter en cAdvisor (host en containers), postgres_exporter, redis_exporter, elasticsearch_exporter en de metrics-endpoints van Traefik, Cantaloupe/Varnish en Authentik.
-
Uptime en synthetische checks. Een blackbox-exporter controleert elk publiek subdomein op bereikbaarheid, TLS-geldigheid en inhoudelijke correctheid (bijv. een valide
info.json, een resolvebare duurzame link en een lopend SPARQL-endpoint). De kritieke e2e-flow draait periodiek als synthetische test, zodat een gebroken keten opvalt vóór een gebruiker het meldt. Uptime Kuma is een lichtgewicht alternatief voor een los statuspagina/uptime-dashboard. -
Logging en tracing. Promtail verzamelt container- en Traefik-accesslogs naar Loki; een doorlopend request-id (gezet in Traefik, doorgegeven aan API en workers) maakt correlatie tussen logs, metrics en traces mogelijk. Distributed tracing is optioneel via OpenTelemetry naar Tempo of Jaeger, nuttig voor het volgen van een upload door API, workers en Cantaloupe.
-
Alerting. Alertmanager stuurt meldingen (e-mail/Slack) op vooraf gedefinieerde SLO’s en foutcondities: endpoint down of trage respons, verhoogde 5xx-ratio, oplopende worker-backlog, volraken van disk of S3, opvallend snel groeiend opslag- of ingestgebruik per organisatie (signaal in plaats van hard quotum, zie de requirements), gefaalde nachtelijke backups en naderend TLS-verloop. Grafana-dashboards per component en per organisatiejottem geven beheerders en moderatoren inzicht, aansluitend op de statistieken die de backend-API al levert.
-
Deployment. De monitoringcomponenten draaien als eigen services in de compose-stack op het
app- endata-netwerk; alleen Grafana wordt via Traefik ontsloten (bijv.status.iotm.nl) achter Authentik-authenticatie, de overige endpoints blijven intern.
Schaalpad. De eerste jaren volstaat een enkele VPS (8 vCPU, 16-32 GB RAM). Groeit het platform, dan schalen frontend, API, workers en Cantaloupe horizontaal het eenvoudigst; PostgreSQL en Elasticsearch verhuizen dan naar managed diensten of eigen nodes. Omdat alle koppelingen via standaardprotocollen lopen (HTTP, S3, OIDC, SPARQL) is die migratie een deployment-vraagstuk, geen architectuurwijziging.
VPS/dedicated server Bij Hetzner (DE) biedt de CCX33 voor €139 per maand (€1.668 per jaar) een VPS met gestelde specificaties. Een dedicated server met betere specs heb je via Hetzner’s "server auction" overigens al voor de helft van dat bedrag.
Zoals eerder gezegd, doordat alle koppelingen standaardprotocollen zijn (HTTP, S3, OIDC, SPARQL) en alles in Docker draait, blijft de overstap naar grotere of meerdere dedicated servers een deployment-vraagstuk, geen architectuurwijziging. Een dedicated server sluit het groeipad dus niet af, hij maakt de eerste stap alleen minder elastisch. Er is wel een kanttekening te maken ten aanzien van beschikbaarheid: bij één dedicated box betekent hardwarefalen downtime tot restore; een cloud-VM kan de provider naar gezonde hardware verplaatsen. Je backups (restic/pgBackRest/IA) dekken dataduurzaamheid, niet uptime. Server-auction-machines zijn bovendien gebruikte hardware.
Voor Jottem is een dedicated server een prima, kostenefficiënte keuze met veel headroom.
6. Samenvatting
| Requirement uit het designdocument | Invulling |
|---|---|
| Laagdrempelig inloggen incl. social login | Authentik met social-login-federatie |
| 2FA/passkeys voor beheerders | Authentik TOTP-/WebAuthn-enrollment + amr-controle in de backend |
| Duurzame ARK-links met NOID/UUID | Arklet + pynoid, registry in PostgreSQL |
| HTML- en RDF-weergave via content negotiation | ARK-resolver met 303-redirects naar frontend resp. Fuseki |
| IIIF Image API (info.json) | Cantaloupe + Varnish op iiif.iotm.nl |
| IIIF Presentation API (manifest/collection) | Backend-API met iiif-prezi3 |
| IIIF Change Discovery | ActivityStreams-feed in backend-API |
| W3C Web Annotations / Annotation Protocol | AnnoRepo op anno.iotm.nl |
| Elasticsearch-zoekfunctie | Elasticsearch, geindexeerd door workers |
| RSS per organisatie | Backend-API |
| schema.org AP NDE + datasetbeschrijvingen | Fuseki op data.iotm.nl + NDE Datasetregister |
| Internet Archive integratie | Workerpool met internetarchive-client |
| Mediaopslag (S3) | externe Object Storage-dienst (S3); MinIO als zelf-gehost alternatief |
| Geo-annotaties (WKT/GeoJSON) | Annotorious + MapLibre, opslag in AnnoRepo/metadata |
| Termen en vocabulaires (CHT, term-URI’s) | NDE Termennetwerk GraphQL API, via backend-proxy met bronnenselectie per project |
| Detectie herkenbare personen (portretrecht) | Herkenbaar API, synchroon aangeroepen bij upload |
| Suggesties bij het uploaden (titel, categorie, steekwoorden) | Suggesties API, aangeroepen tussen stap 1 en stap 2; nooit blokkerend |
| Geautomatiseerd testen | CI-pipeline: unit/integratie (pytest, Vitest), contracttests op IIIF/W3C/SHACL/SPARQL, e2e met Playwright |
| Monitoring, logging en alerting | Prometheus + exporters, Grafana, Loki/Promtail, Alertmanager, blackbox-/synthetische checks |
| Subdomeinen | Traefik-routing: www, api, iiif, ark, anno, auth, data, status |